「从源头不收集」:DuckDuckGo 的隐私设计思路与普通浏览器的差别
一个反常识的出发点
多数隐私方案的逻辑是"先收集、再承诺管好":浏览器记录你的历史,然后提供隐身模式让你手动清除;广告平台建立你的档案,然后给你退出选项。DuckDuckGo 的官方表述把这个顺序倒了过来——防范黑客、骗子与窥探型企业最可靠的办法,是让信息从一开始就不被收集。
这句口号听起来抽象,但它解释了这款产品几乎所有功能的设计取向:
- 搜索引擎不保存搜索历史,所以不存在"历史泄露"这回事;
- 浏览器在跟踪器加载之前拦截请求,对方连拿到 IP 地址的机会都没有;
- 密码保存在本机、同步走端到端加密,服务器侧想看也看不到;
- AI 聊天先做匿名化再转发给模型提供商,对话不进训练数据。
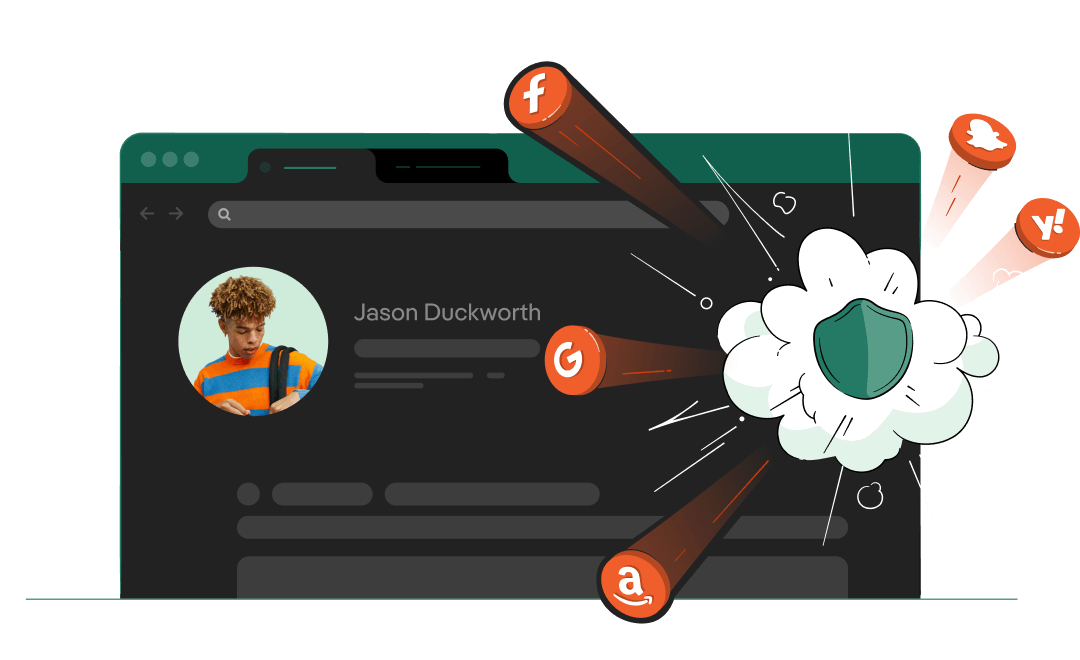
对比:加载后限制 vs 加载前拦截
这是理解它与其他浏览器差别最重要的一页知识。多数主流浏览器的"跟踪防护"处理的是 Cookie 与指纹这类加载之后的行为——跟踪器脚本已经运行,只是拿到的信息受限。但请求发出时附带的 IP 地址等标识信息,在加载环节就已经交出去了。
DuckDuckGo 的第三方跟踪器加载拦截(3rd-Party Tracker Loading Protection)选择在更早的环节动手:依靠自家的 Tracker Radar 爬虫持续扫描网络、维护公开的跟踪器名单,命中名单的第三方跟踪请求直接不让发出。这个能力在它所有应用与扩展里默认开启。
这套思路的代价
没有任何防护是免费的,"从源头拦截"同样有代价:
- 拦得越狠,站点功能坏掉的概率越高。它用"替身脚本"(Surrogates)、远程配置的有限例外等手段保功能,但偶尔仍需手动放行;
- 名单驱动的拦截依赖持续爬取与更新,新出现的跟踪域名可能有窗口期;
- 匿名化做得越彻底,某些"方便"就没了——例如搜索结果不显示结果总数,就与多源匿名聚合的架构有关。
如何验证这套理念落在实处
- 看代码:绝大多数应用、扩展与跟踪器名单都开源,普通用户可以自行审查;
- 看行为:在浏览器里打开任意带第三方跟踪器的站点,点地址栏旁的盾牌图标,能看到具体拦了哪几家、拦了多少次;
- 看承诺边界:隐私政策明确哪些数据不收、哪些数据(如搜索广告的记账需要)会以何种匿名程度处理。